Kubernetes muss nicht immer gleich aus mehreren hochverfügbaren Nodes und einem komplexen Storage-Backend bestehen. Gerade im Homelab kann bereits ein einzelner leistungsfähiger Mini-PC ausreichen, um eine kleine Kubernetes-Umgebung aufzubauen und verschiedene Anwendungen zentral zu betreiben.
In diesem Artikel schauen wir uns an, wie wir eine solche Umgebung mit möglichst wenigen Komponenten in Betrieb nehmen. Als Basis verwenden wir Rocky Linux 10, containerd und kubeadm. Anschließend installieren wir Flux CD, um die Verwaltung des Clusters nach dem GitOps-Prinzip zu automatisieren.
Für die Bereitstellung persistenten Speichers setzen wir zusätzlich auf den Local Path Provisioner von Rancher. Und da eine komfortable Weboberfläche zur Administration in einem Homelab natürlich nicht fehlen darf, schauen wir uns außerdem Headlamp als Kubernetes-Dashboard an.
Das Ziel ist eine schlanke Kubernetes-Umgebung, deren Konfiguration vollständig in einem Git-Repository liegt. Anstatt Änderungen manuell mit kubectl vorzunehmen, verwalten wir den gewünschten Zustand deklarativ über Git. Flux CD übernimmt die automatische Synchronisierung mit dem Git-Repository.
Als zentrale Ablage für die Kubernetes-Konfigurationen dient eine selbst gehostete Gitea-Instanz auf einem separaten Docker-Node. Das Git-Repository bildet hier die Quelle für den gewünschten Zustand der gesamten Umgebung – die sogenannte Source of Truth. Wie das Ganze zusammenspielt und wie die einzelnen Komponenten aufgebaut sind, schauen wir uns im Folgenden genauer an.
ℹ️ Noch ein Hinweis:
Bei diesem Beitrag handelt es sich bewusst nicht um eine vollständige Schritt-für-Schritt-Anleitung zur Installation aller Komponenten. Vielmehr möchte ich die grundlegende Architektur vorstellen, das Zusammenspiel der einzelnen Komponenten erläutern und ein Verständnis dafür vermitteln, wie sich GitOps auch mit überschaubarem Aufwand im eigenen Homelab umsetzen lässt.
Architektur & Komponenten:
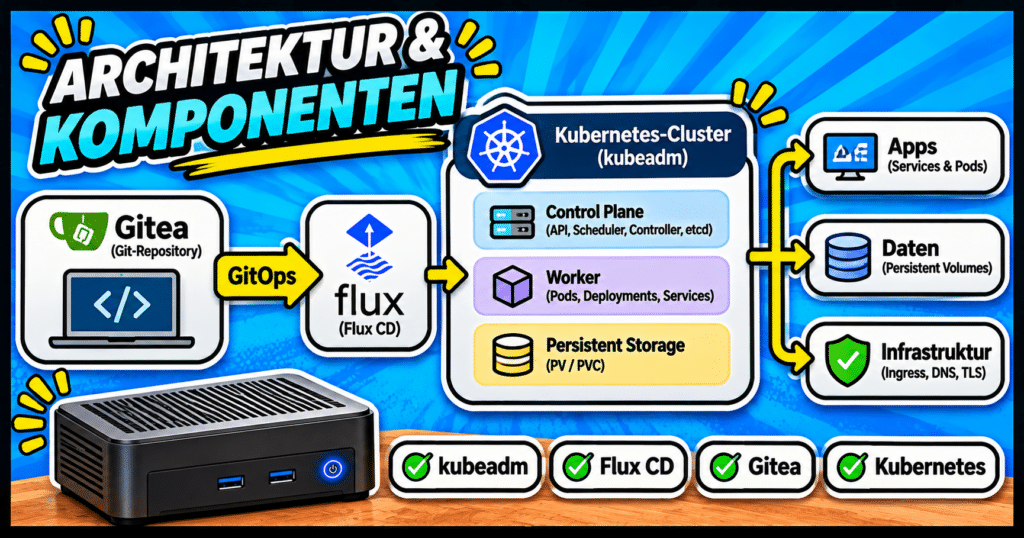
Der Aufbau ist bewusst minimalistisch gehalten. Anstatt mehrere Kubernetes-Nodes, eine gigantische Management-Plattform und ein verteiltes Storage-Backend aufzubauen, konzentrieren wir uns auf die wesentlichen Komponenten, die für einen funktionierenden GitOps-Workflow notwendig sind.
Als Grundlage dient ein einzelner Mini-PC, auf dem sowohl die Kubernetes-Control-Plane als auch die eigentlichen Workloads betrieben werden. Für ein Homelab, in dem primär verschiedene Dienste und Anwendungen zentral bereitgestellt werden sollen, ist dieses Setup vollkommen ausreichend.
Kubernetes mit kubeadm und containerd:
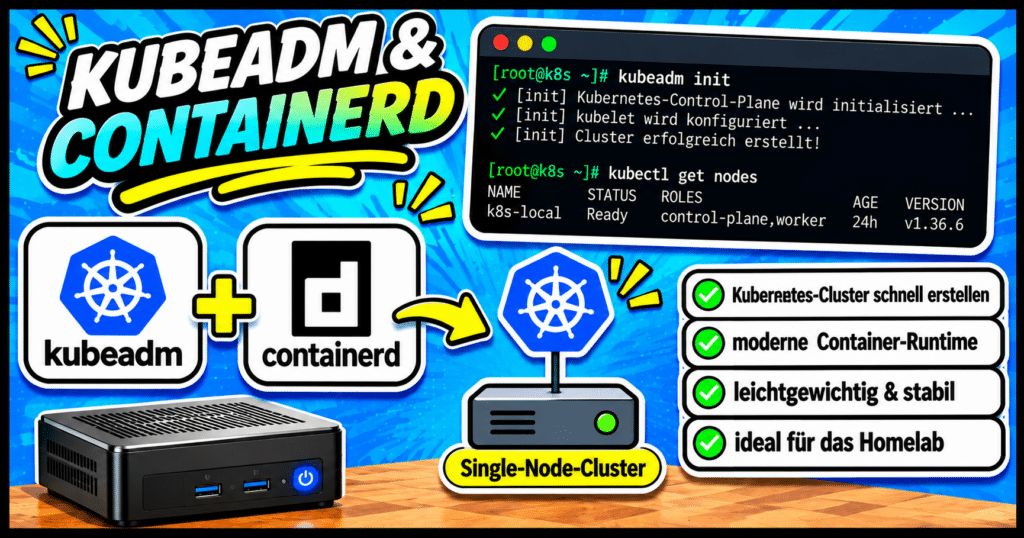
Für die Bereitstellung des Clusters kommt kubeadm zum Einsatz. Im Gegensatz zu Komplettdistributionen wie K3s oder MicroK8s bietet kubeadm einen vergleichsweise schlanken und standardnahen Einstieg in Kubernetes. Die einzelnen Komponenten werden dabei weitgehend selbst verwaltet, wodurch man sich intensiver mit der Funktionsweise und dem Zusammenspiel auseinandersetzt.
Als Container Runtime verwenden wir containerd. Diese übernimmt die Ausführung und Verwaltung der Container auf dem Node und ist über das Container Runtime Interface (CRI) direkt an Kubernetes angebunden. Eine separate Docker-Installation ist auf dem Kubernetes-Node nicht erforderlich.
Für die direkte Interaktion mit der Container Runtime stehen mit ctr bereits die containerd-eigenen Kommandozeilenwerkzeuge zur Verfügung. Zusätzlich habe ich crictl installiert, das speziell für die Verwaltung und Diagnose von Containern über das Container Runtime Interface (CRI) vorgesehen ist.
💡 Gut zu wissen:
Kubeadm bringt weder ein Container Network Interface (CNI) noch einen Ingress-Controller mit. Nach der Initialisierung des Clusters muss daher zunächst ein CNI-Plugin wie Flannel oder Calico installiert werden, damit die Pods untereinander kommunizieren können.
Ein Ingress-Controller, beispielsweise NGINX Ingress oder Traefik, muss bei Bedarf ebenfalls separat bereitgestellt werden. Beides gehört nicht zum standardmäßigen Installationsumfang von kubeadm.
Flux CD und Gitea als GitOps-Basis:
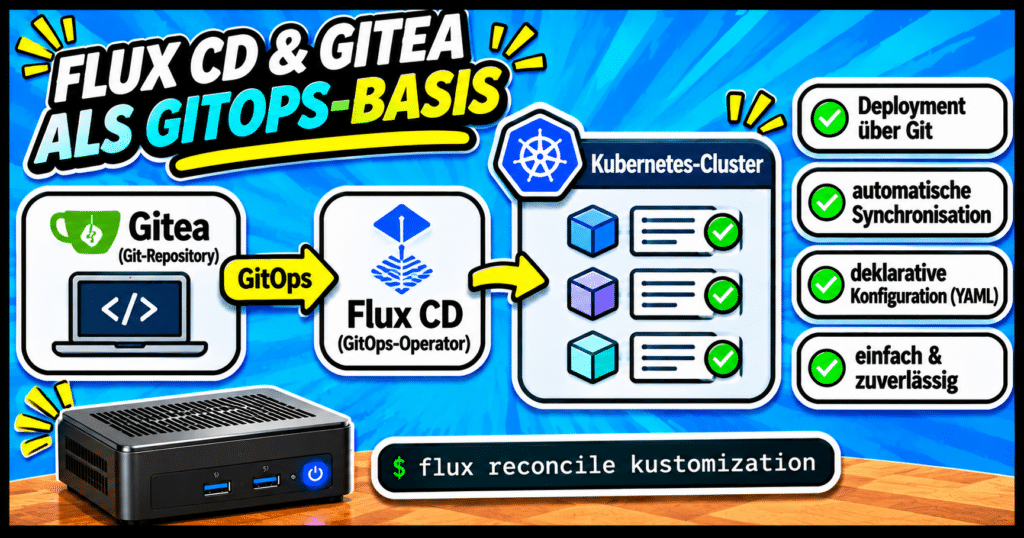
Das Herzstück der Architektur bildet Flux CD. Die GitOps-Komponenten laufen direkt innerhalb des Kubernetes-Clusters und übernehmen die kontinuierliche Überwachung sowie Synchronisierung des hinterlegten Git-Repositories.
Als Git-Server kommt eine bereits vorhandene Gitea-Instanz zum Einsatz. Diese läuft unabhängig vom Kubernetes-Cluster als Docker-Container auf einem separaten Docker-Node. Diese Trennung ist durchaus sinnvoll: Selbst wenn der Kubernetes-Cluster einmal nicht verfügbar ist, bleibt das Git-Repository weiterhin erreichbar.
Die Konfiguration des Clusters ist somit unabhängig von der Infrastruktur verfügbar, die sie eigentlich verwaltet. Das Repository enthält sämtliche Kubernetes-Manifeste und Helm-Konfigurationen, die den gewünschten Zustand der Umgebung beschreiben. Flux CD gleicht diesen Zustand regelmäßig mit dem tatsächlichen Zustand des Clusters ab.
Änderungen werden über Git-Commits eingebracht und anschließend automatisch umgesetzt. Dadurch entsteht ein deklarativer Verwaltungsansatz, bei dem nicht mehr einzelne Ressourcen manuell verändert werden müssen. Wer den Automatisierungsgrad noch weiter erhöhen möchte, kann zusätzlich eine Überwachung auf verfügbare Container-Image-Updates integrieren.
Tools wie Renovate oder Flux Image Automation können beispielsweise erkennen, wenn für verwendete Images neue Versionen verfügbar sind, und entsprechende Aktualisierungen automatisiert vorbereiten oder das neue Image-Tag direkt in das Git-Repository als Branch übernehmen.
💡 Gut zu wissen:
Für die initiale Installation und Einrichtung von Flux CD wird einmalig die Flux CLI benötigt. Diese muss allerdings nicht auf dem Kubernetes-Node installiert werden, sondern kann bequem auf dem eigenen Administrationsrechner ausgeführt werden.
Die eigentliche Arbeit übernehmen anschließend die Flux-Controller, die direkt im Kubernetes-Cluster laufen. Die CLI wird für den laufenden GitOps-Betrieb nicht benötigt und kann daher vom Kubernetes-Node ferngehalten werden.
Local Path Provisioner:
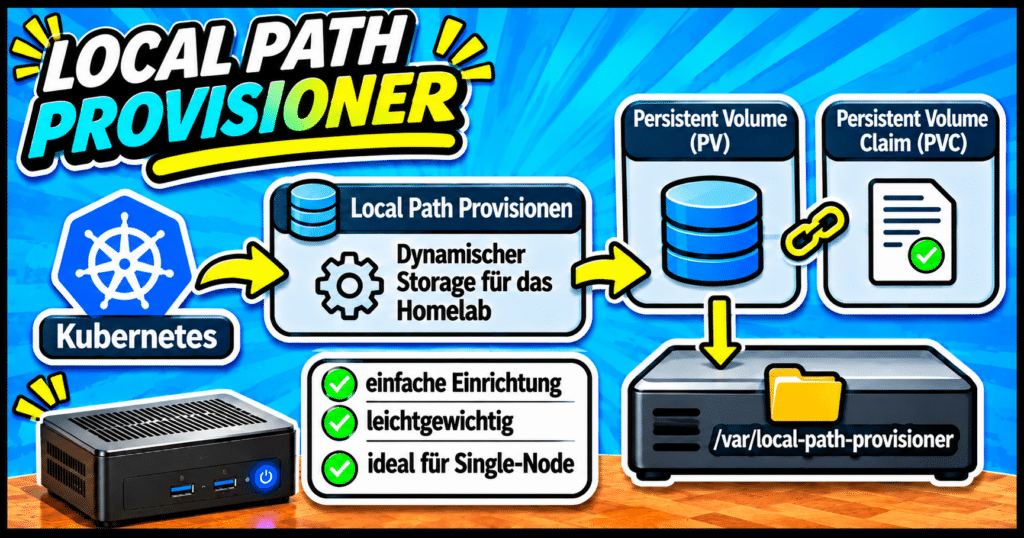
Auch in einem kleinen Cluster benötigen Anwendungen häufig persistenten Speicher. Dazu zählen beispielsweise Konfigurationsdaten, Datenbanken oder hochgeladene Dateien. Für diesen Anwendungsfall setzen wir auf den Local Path Provisioner von Rancher.
Dieser stellt über eine Kubernetes-StorageClass dynamisch lokale PersistentVolumes bereit. Die Daten werden dabei direkt auf dem Dateisystem des Kubernetes-Nodes abgelegt. Ein separates Storage-System oder ein zusätzlicher Storage-Cluster sind dafür nicht erforderlich.
Die Lösung ist bewusst einfach gehalten und eignet sich insbesondere für einen Single-Node-Cluster. Eine Replikation der Daten oder Hochverfügbarkeit bietet sie allerdings nicht. Fällt der Node aus, sind auch die darauf gespeicherten Daten zunächst nicht verfügbar. Für ein kleines Homelab ist dieser Kompromiss häufig vertretbar, sofern eine geeignete Backup-Strategie vorhanden ist.
💡 Gut zu wissen:
Der Local Path Provisioner sollte als Default-StorageClass eingerichtet und idealerweise direkt über Flux CD ausgerollt werden. So ist auch die Storage-Infrastruktur vollständig Bestandteil deiner GitOps-Konfiguration.
Falls du ihn bereits mit kubectl installiert hast, ist das aber kein Problem: Die bestehenden Ressourcen lassen sich nachträglich in die Verwaltung durch Flux übernehmen. Eine Neuinstallation ist dafür nicht erforderlich.
Headlamp als Admin-Dashbaord:
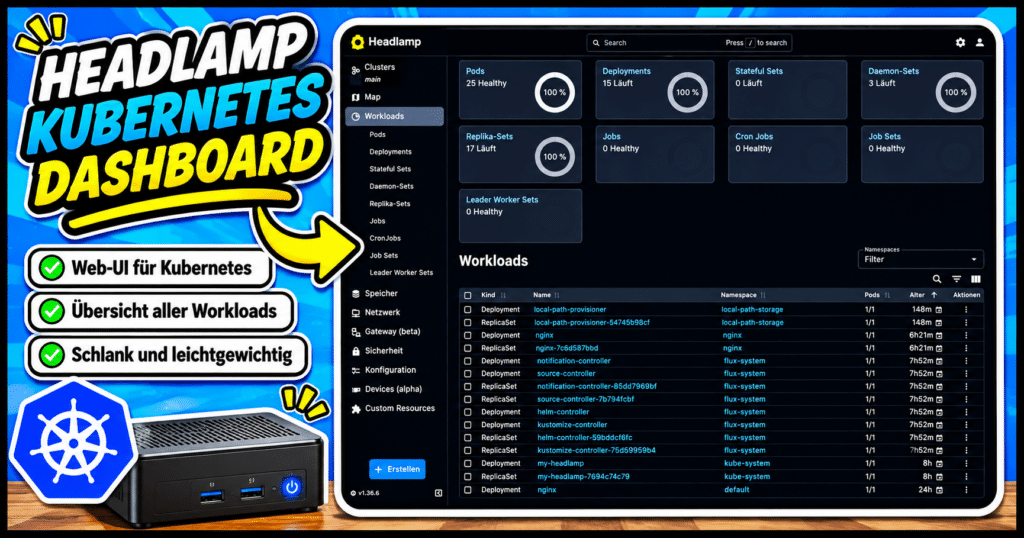
Obwohl sich Kubernetes vollständig über kubectl und deklarative Manifeste verwalten lässt, ist eine grafische Oberfläche im Alltag durchaus praktisch. Hierfür setzen wir Headlamp ein.
Das Tool stellt eine Weboberfläche zur Verfügung, über die sich beispielsweise Deployments, Pods, Services, Namespaces und weitere Kubernetes-Ressourcen visualisieren und administrieren lassen. Gerade bei der Fehlersuche oder zur schnellen Kontrolle des Cluster-Zustands ist das eine hilfreiche Ergänzung zur Kommandozeile.
Wichtig ist dabei die Rollenverteilung: Headlamp dient als Administrationsoberfläche, während Flux CD weiterhin die deklarative Verwaltung der GitOps-Ressourcen übernimmt. Manuelle Änderungen an Flux-verwalteten Ressourcen können durch die nächste Synchronisierung wieder zurückgesetzt werden.
Die dauerhafte Konfiguration sollte deshalb grundsätzlich im Git-Repository erfolgen. Headlamp spielt seine Stärken vor allem bei der Fehlersuche und der schnellen Analyse des Cluster-Zustands aus. So lassen sich beispielsweise Events und Logs einsehen oder die Struktur und Zusammenhänge der Ressourcen innerhalb eines Namespaces übersichtlich visualisieren.
💡 Gut zu wissen:
Auch Headlamp sollte idealerweise direkt über Flux CD und ein HelmRelease installiert werden. Dadurch wird das Kubernetes-Dashboard vollständig deklarativ verwaltet und die verwendete Chart-Version sowie sämtliche Konfigurationsparameter sind zentral im Git-Repository dokumentiert.
Falls Headlamp bereits manuell über Helm installiert wurde, ist das kein Problem: Eine bestehende Helm-Installation lässt sich nachträglich von Flux übernehmen. Eine Deinstallation und anschließende Neuinstallation ist dafür nicht erforderlich.
Zusammenspiel der Komponenten:
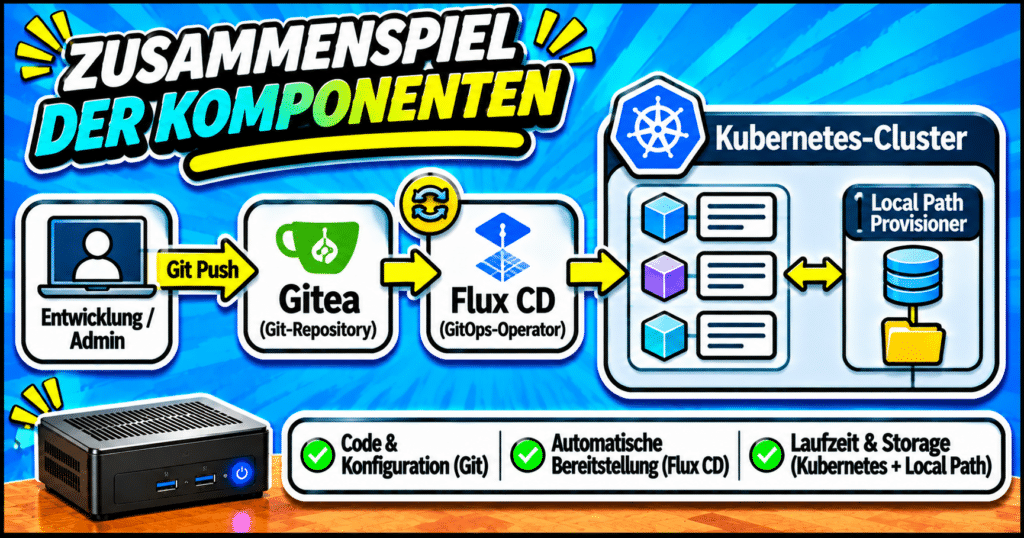
Die einzelnen Bausteine übernehmen innerhalb der Architektur klar voneinander getrennte Aufgaben und ergänzen sich zu einer schlanken, modularen Kubernetes-Umgebung mit geringem Ressourcenverbrauch:
- Rocky Linux 10: Stabile Enterprise-Linux-Basis für den Kubernetes-Node mit langfristiger Unterstützung und RHEL-Kompatibilität.
- Containerd: Schlanke Container Runtime zur Ausführung der Kubernetes-Workloads. Für die lokale Verwaltung und Diagnose stehen ctr sowie das zusätzlich installierte crictl zur Verfügung.
- Kubeadm: Initialisierung und Verwaltung des Kubernetes-Clusters.
- Rancher Local Path Provisioner: Dynamische Bereitstellung von persistentem Speicher in Form lokaler Verzeichnisse auf dem Host-Dateisystem.
- Flux CD: Kontinuierliche Synchronisierung der Kubernetes-Konfigurationen via Pull-Verfahren mittels SSH-Verbindung zum Git-Repository.
- Gitea: Schlanker, selbst gehosteter Git-Server auf Containerbasis als zentrale und versionierte Ablage der Cluster-Konfigurationen – eine kompakte Alternative zu etablierten Plattformen wie GitLab.
- Headlamp: Grafische Oberfläche zur Beobachtung und Administration des Kubernetes-Clusters, die entweder direkt im Cluster oder lokal auf einem Administrationsrechner betrieben werden kann.
Mit den vorgestellten Komponenten erhalten wir eine bewusst schlank gehaltene und ressourcenschonende Architektur, die auch auf einem kleineren Mini-PC problemlos betrieben werden kann. Jede Komponente erfüllt einen klar definierten Zweck, ohne unnötigen Overhead oder zusätzliche Management-Ebenen einzuführen.
Gleichzeitig verzichten wir nicht auf zentrale Funktionen wie automatisierte Deployments, Versionsverwaltung und persistenten Speicher. Das Setup bietet damit einen guten Kompromiss zwischen geringem Ressourcenbedarf und Funktionalität und lässt sich bei Bedarf jederzeit um weitere Anwendungen, Helm-Releases oder Infrastrukturkomponenten über GitOps erweitern.
💡 Gut zu wissen:
Der Kubernetes-Node muss nicht zwingend auf dedizierter Hardware betrieben werden. Das gesamte Setup lässt sich ebenso problemlos als VM betreiben. Empfehlenswert sind ein NVMe-Storage-Pool für geringe Latenzen und hohe IOPS sowie der CPU-Typ host, damit die VM möglichst performant ist.
Klein anfangen, flexibel wachsen:
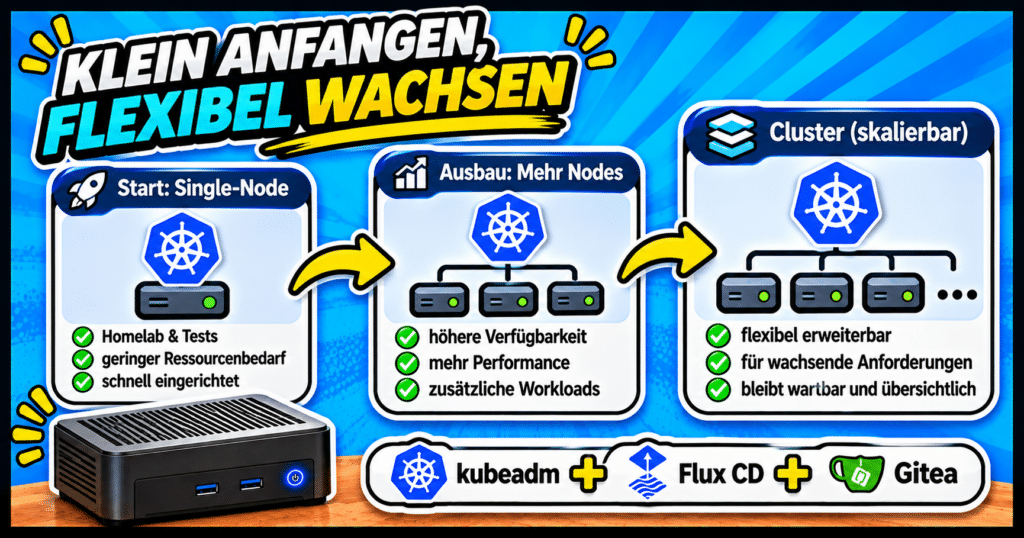
Mit dem hier vorgestellten Setup betreibe ich selbst meinen Kubernetes-Cluster. Die Kombination aus kubeadm, containerd, Flux CD, Gitea, Local Path Provisioner und Headlamp bietet eine stabile und vergleichsweise schlanke Umgebung, mit der sich erste praktische Erfahrungen mit GitOps sammeln lassen.
Man bekommt ein gutes Verständnis dafür, wie deklarative Konfigurationen, Git-Repositories und Kubernetes-Controller zusammenspielen, ohne direkt eine umfangreiche Infrastruktur aufbauen und betreiben zu müssen. Wer allerdings bereits absehen kann, dass die eigene Umgebung langfristig wachsen soll, sollte einige architektonische Entscheidungen möglichst früh treffen.
Storage – Frühzeitig an die Skalierung denken:
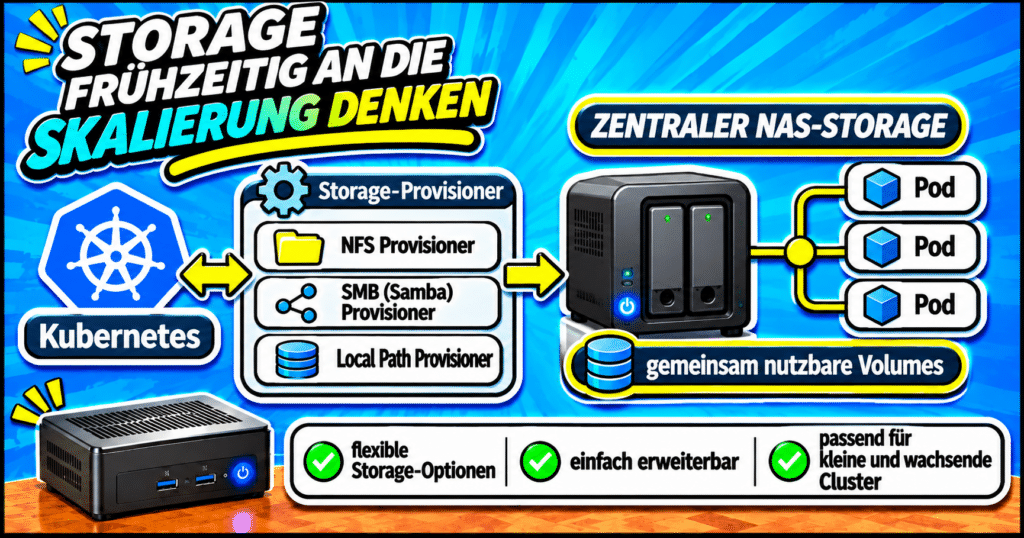
Ein gutes Beispiel ist die Storage-Anbindung: Der Local Path Provisioner ist für einen Single-Node-Cluster vollkommen ausreichend, bindet die Daten allerdings direkt an den jeweiligen Node. Wer später mehrere Kubernetes-Nodes betreiben oder Workloads flexibel zwischen diesen verschieben möchte, sollte von Anfang an über einen zentralen Storage nachdenken.
Ein NFS-Provisioner in Verbindung mit einem vorhandenen NAS wäre hier beispielsweise eine einfache Möglichkeit. Damit lassen sich PersistentVolumes unabhängig vom jeweiligen Kubernetes-Node bereitstellen und spätere Datenmigrationen vermeiden.
💡 Gut zu wissen:
Wer bereits zu Beginn einen S3-kompatiblen Objektspeicher in seinem Homelab benötigt, sollte sich zwei schlanke Container ansehen: Garage ist besonders ressourcenschonend ausgelegt und kommt daher ohne eigene grafische Verwaltungsoberfläche aus. RustFS bietet hingegen eine Web-GUI.
GitOps – Eine saubere Struktur schaffen:
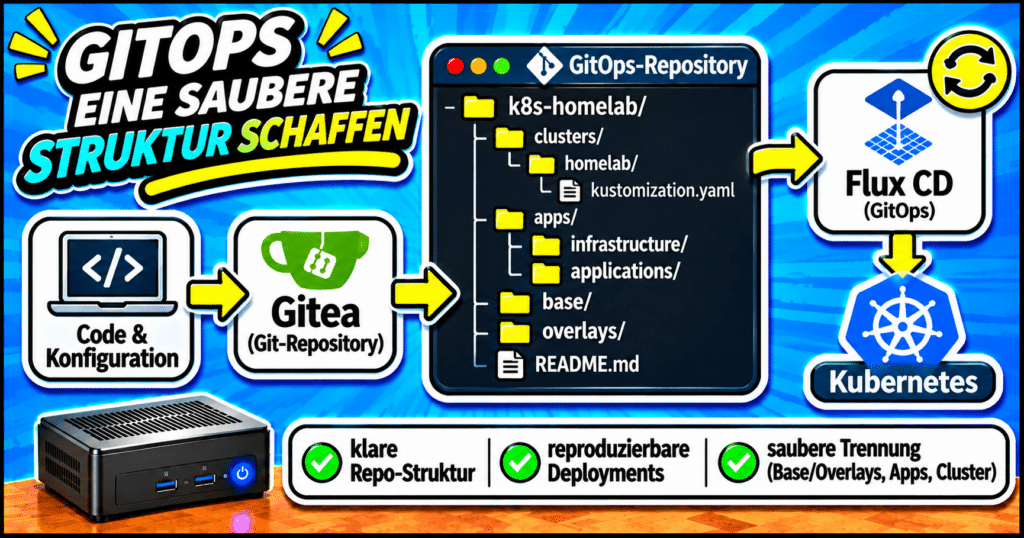
Auch bei der Verzeichnisstruktur des Git-Repositories und der Trennung von Infrastruktur und Anwendungen lohnt es sich, bereits zu Beginn etwas weiter vorauszudenken. Ich habe mich beispielsweise dafür entschieden, mein Repository nach Clustern und diese in die Bereiche infrastructure und apps aufzuteilen.
Unter infrastructure liegen zentrale Komponenten wie Storage-Provisioner, Netzwerkkomponenten und weitere clusterweite Dienste. Unter apps werden dagegen die eigentlichen Anwendungen wie Homarr verwaltet. Diese Trennung zahlt sich spätestens dann aus, wenn die Umgebung wächst.
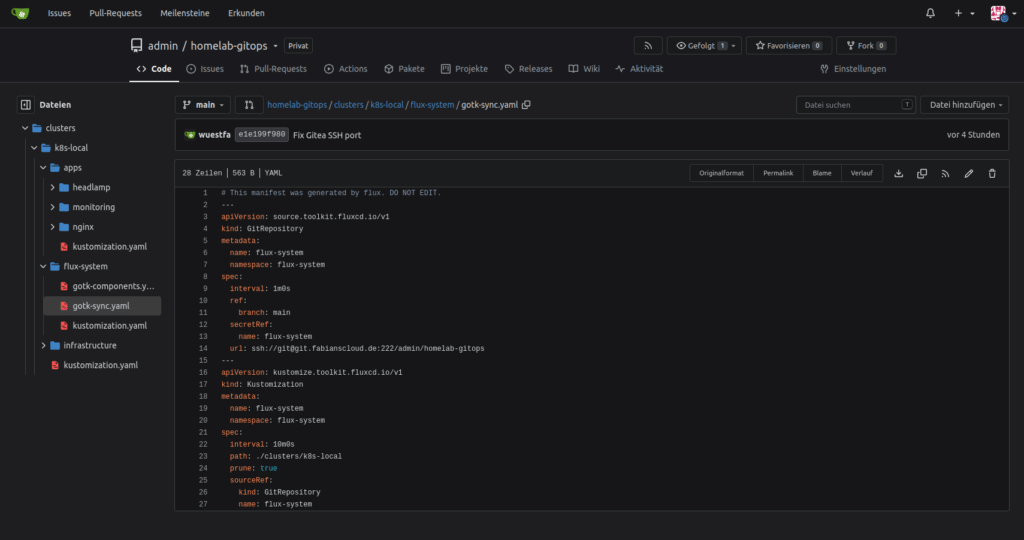
Möchte man beispielsweise später einen zweiten Kubernetes-Cluster aufbauen, zusätzliche Infrastrukturkomponenten integrieren oder Anwendungen unabhängig voneinander verwalten, lässt sich die bestehende Struktur gezielt erweitern. Auch eine Aufteilung nach Umgebungen wie homelab, staging und production wäre damit problemlos möglich.
Ebenfalls interessant sind die Verzeichnisse base und overlays. Sie ermöglichen es, gemeinsame Kubernetes-Konfigurationen wiederzuverwenden und gezielt umgebungsspezifische Anpassungen vorzunehmen, ohne dieselben Manifeste mehrfach pflegen zu müssen.
Das ist besonders hilfreich, wenn du beispielsweise:
- Entwicklungs- und Produktivcluster parallel betreibst.
- Dieselben Anwendungen mit unterschiedlichen Ressourcenlimits ausrollst.
- Mehrere Cluster auf Basis einer gemeinsamen Grundkonfiguration verwaltest.
- Einzelne Anwendungen je Cluster unterschiedlich konfigurierst.
Mithilfe der obigen Tipps bleibt das Repository übersichtlich und Änderungen an der gemeinsamen Basis müssen nur an einer Stelle vorgenommen werden. So hat man von Anfang an eine Struktur geschaffen, die mit der eigenen Infrastruktur mitwachsen kann.
Mit einer überschaubaren Architektur lässt sich bereits eine stabile Umgebung aufbauen, die genügend Möglichkeiten zum Experimentieren und Lernen bietet. Wichtig ist lediglich, zwischen bewusst einfachen Entscheidungen für den Einstieg und solchen zu unterscheiden, die bei einer späteren Skalierung aufwendige Migrationen nach sich ziehen könnten.